Ngày 30-10, 4 tập đoàn công nghệ, gồm OpenAI, Google, Microsoft và Anthropic, công bố ủng hộ 1 tín hiệu kỹ thuật chung, giúp các website thể hiện rõ việc có đồng ý cho phép nội dung được sử dụng để huấn luyện AI hay không.
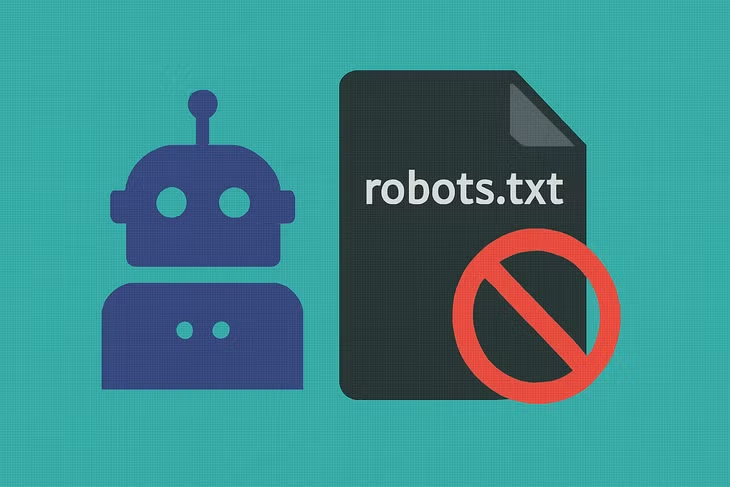
Theo đề xuất, chủ sở hữu website có thể đưa một đoạn mã vào tệp robots.txt, tập tin vốn được sử dụng để hướng dẫn các chương trình tự động truy cập và thu thập dữ liệu trên website.
Trong khi đó, đoạn mã mới mang tên __usage_ai-training, cho phép các công ty AI nhận biết nội dung nào được chủ sở hữu cho phép sử dụng để huấn luyện mô hình.
Trước đây, các cơ quan báo chí và nhà xuất bản thường phải thiết lập quy tắc riêng đối với từng công ty công nghệ.
Vì vậy, việc xây dựng tín hiệu chung được kỳ vọng giúp đơn giản hóa quá trình kiểm soát, đồng thời giảm công sức cho các đơn vị sở hữu nội dung.
Về lộ trình triển khai, Anthropic đã bắt đầu hỗ trợ cơ chế này. OpenAI dự kiến áp dụng trong những tháng tới, Google đặt mục tiêu thực hiện trong năm 2027, còn Microsoft cho biết sẽ bắt đầu tôn trọng lựa chọn của các website từ ngày 1-2-2027.
Tuy nhiên, cơ chế mới không có nghĩa là các website có thể chặn hoàn toàn mọi hoạt động thu thập dữ liệu của AI.
Tín hiệu này chủ yếu thể hiện việc chủ sở hữu có cho phép sử dụng nội dung để huấn luyện mô hình hay không. Những hoạt động khác, như thu thập dữ liệu để phục vụ tìm kiếm hoặc cung cấp thông tin cho người dùng, vẫn được điều chỉnh bằng các quy tắc riêng.
Sáng kiến được đưa ra trong bối cảnh nhiều cơ quan báo chí và nhà xuất bản phản đối việc các công ty AI sử dụng bài viết, hình ảnh và dữ liệu trên Internet để phát triển mô hình mà không có sự đồng ý hoặc thỏa thuận cấp phép.
Tranh chấp bản quyền giữa các nhà xuất bản và doanh nghiệp công nghệ ngày càng gia tăng. Một trong những vụ việc đáng chú ý là đơn kiện của báo The New York Times đối với OpenAI và Microsoft năm 2023, liên quan đến cáo buộc sử dụng hàng triệu bài báo để huấn luyện AI.
Meta cũng bày tỏ ủng hộ ý tưởng xây dựng tín hiệu chung, nhưng chưa xác nhận tham gia triển khai.